
ChatGPT API Integration: Der praxisnahe Weg zur sicheren Anbindung
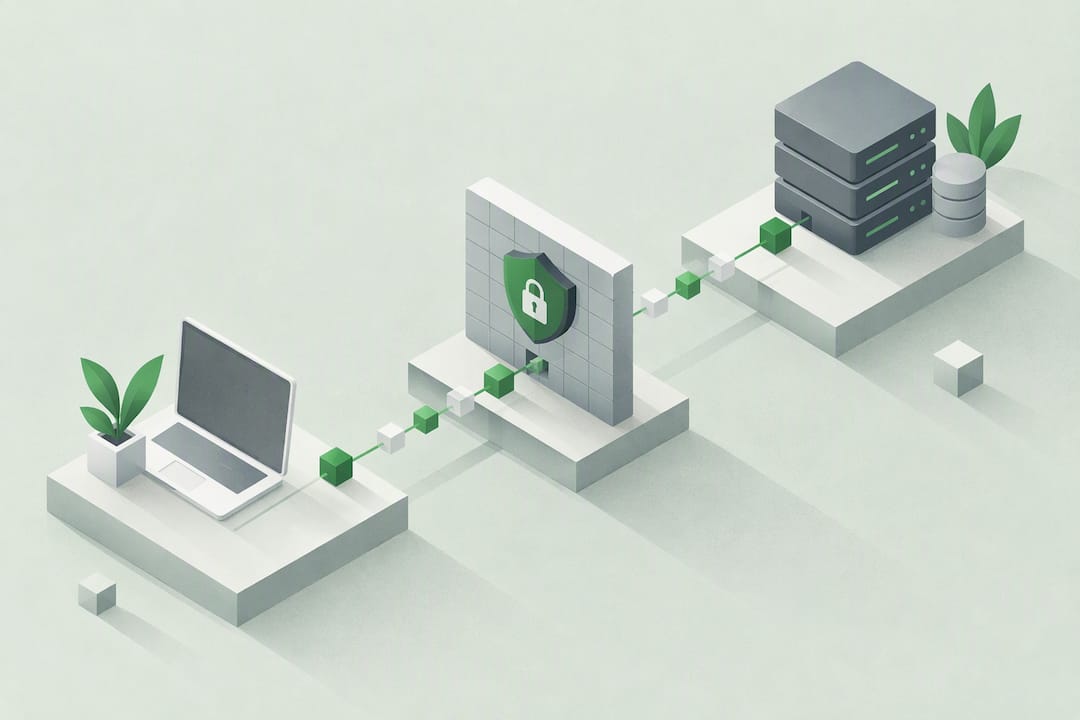
Für neue Projekte setzen wir auf die Responses API, serverseitig hinter einem Backend-Proxy mit sicherer Schlüsselverwaltung und IP-Allowlisting. Als ersten Schritt legen wir eine Proxy-Route an, etwa /api/chat, die niemals den Schlüssel an das Frontend weitergibt. Danach folgen Organisation und API-Schlüssel in OpenAI, bevor wir Schlüsselrotation und Zugriffsbeschränkung für den Produktivbetrieb einrichten.
Kurz gesagt:
- Der Zugangsschlüssel für die API bleibt ausschließlich im Backend; eine Proxyroute authentifiziert Anfragen, bereinigt Eingaben und protokolliert Metadaten, aber keine sensiblen Nutzerinhalte, bevor sie diese weiterleitet.
- Eine Freigabeliste erlaubt bis zu 50 Internetadressen oder Adressbereiche; Änderungen können laut OpenAI bis zu 15 Minuten benötigen, bis sie wirksam werden.
- Ein Schema im JSON-Format eignet sich für strukturierte Ergebnisse wie Kategorisierungen; Funktionsaufrufe passen, wenn das Modell externe Aktionen wie Datenbankabfragen anstoßen soll.
- Bei Fehlern wegen Ratenlimits sollten Anfragen mit exponentiell wachsenden Wartezeiten und zufälliger Streuung wiederholt werden, statt sie sofort erneut zu senden.
Responses API vs. Chat Completions: Welche Wahl für welchen Use Case?
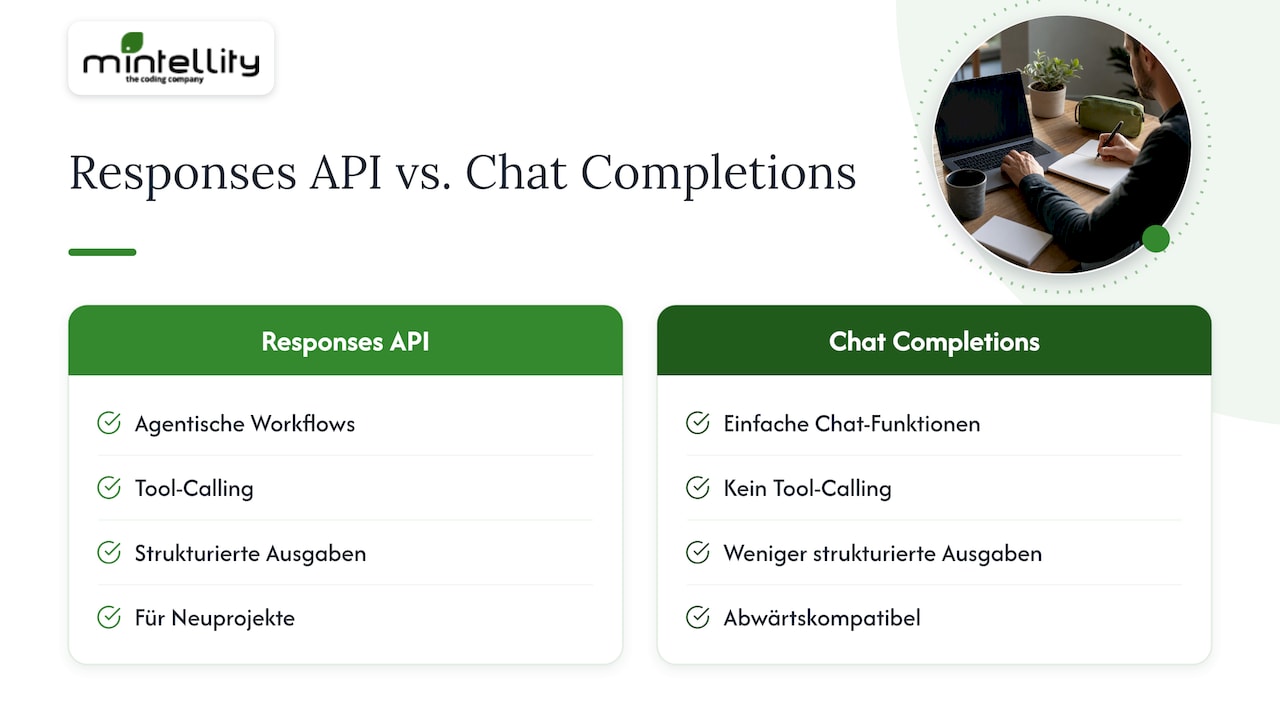
Für agentische Workflows, Tool-Calling und strukturierte Ausgaben empfiehlt sich die Responses API, die den Übergang von einfachen Prototypen zu produktiven, werkzeuggestützten Anwendungen erleichtert und die Integrationskomplexität für Funktionsaufrufe senkt. Die ältere Chat Completions API bleibt dagegen sinnvoll, wenn es nur um einfache Chat-Funktionen geht oder eine bestehende Integration abwärtskompatibel bleiben muss.
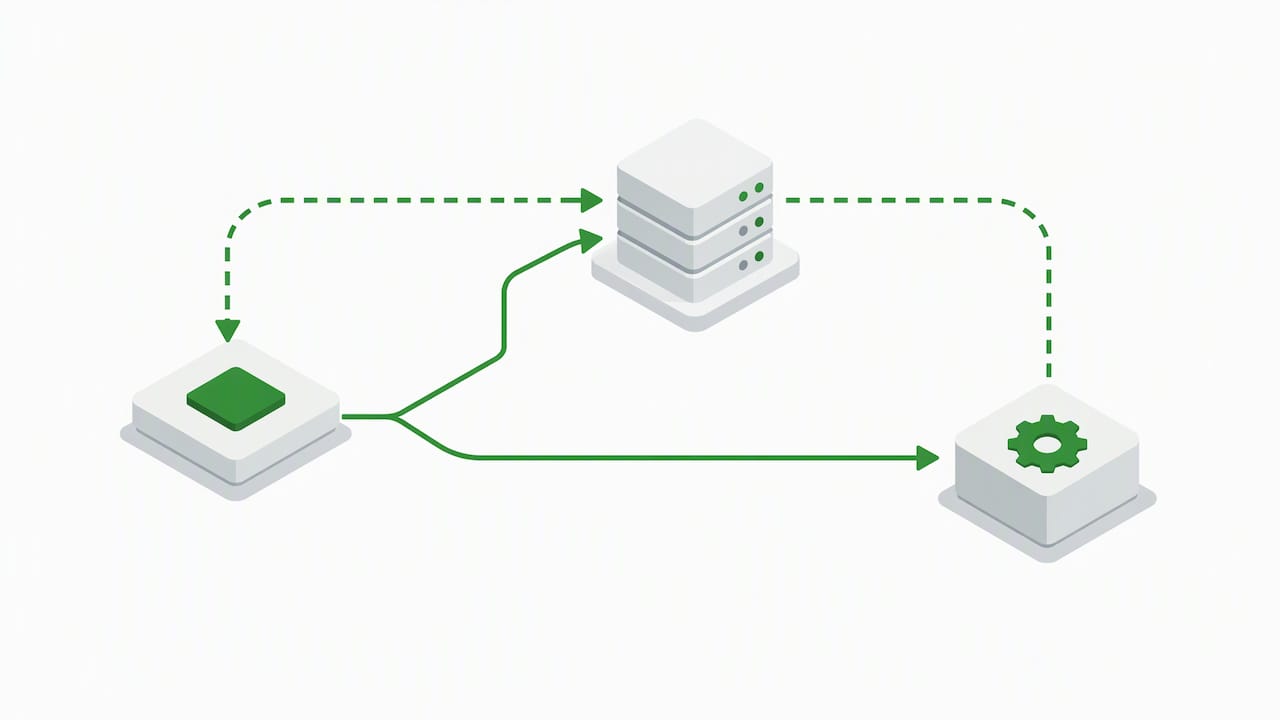
Architektonisch ändert sich wenig zwischen beiden Varianten: Ein Backend-Proxy nimmt Anfragen vom Client entgegen, reichert sie mit Kontext an und leitet sie an OpenAI weiter. Caching häufiger Antworten und eine durchdachte Kontextverwaltung sparen dabei Tokens und Zeit. Wer heute ein neues Projekt startet, sollte direkt mit der Responses API planen und sich nicht erst später mit einer Migration beschäftigen müssen.
Voraussetzungen: Accounts, Rollen, Preise und Testumgebungen schaffen
Bevor der erste Codeaufruf steht, braucht es eine Organisation in der OpenAI-Plattform mit klar vergebenen Rollen und einer durchdachten Governance für API-Schlüssel. Wer Zugriff auf Produktionsschlüssel hat, sollte von vornherein begrenzt sein, und jede Rolle bekommt nur die Berechtigungen, die sie tatsächlich braucht.
Bei den Kosten zählen drei Faktoren: die Modellwahl, der tatsächliche Tokenverbrauch und mögliche Anforderungen an regionale Datenverarbeitung. Eine grobe Budgetabschätzung vorab verhindert spätere Überraschungen bei der Abrechnung.
Für Staging und Produktion legen wir getrennte Umgebungen mit eigenen Schlüsseln an und prüfen die geltenden Testkontingente, damit ein Lasttest nicht versehentlich das Produktionslimit sprengt.
API-Zugang einrichten und sicheren Backend-Proxy implementieren
Der Schlüssel entsteht in der Organisation, nie im Code und nie im Frontend. Danach braucht es eine Route, die Anfragen entgegennimmt, validiert und erst dann an OpenAI weiterleitet.
- Schlüssel in der Organisation erzeugen, mit Ablaufdatum versehen und in einem Secrets Manager ablegen, niemals im Repository.
- Eine Proxy-Route bauen, die eingehende Anfragen authentifiziert, Nutzereingaben bereinigt und nur notwendige Felder weiterreicht.
- Logging einrichten, das Metadaten erfasst, aber keine sensiblen Nutzerinhalte speichert.
- Eine IP-Allowlist konfigurieren, die bis zu 50 IP-Adressen oder DDR-Blöcke zulässt; Änderungen können laut OpenAI bis zu 15 Minuten wirksam werden.
- Mit einem einfachen Testaufruf prüfen, ob die Route antwortet, bevor echte Nutzer darauf zugreifen.
Dieses Grundgerüst hält den Schlüssel dort, wo er hingehört: serverseitig, geschützt und austauschbar.
Profi-Tipp: Setzen Sie ein kurzes Ablaufdatum für Testschlüssel, damit vergessene Entwicklungszugänge nicht monatelang offen bleiben.
Python-Quickstart: Minimaler Serveraufruf der Responses API mit JSON-Schema
Ein schlanker FastAPI-Endpunkt reicht, um die Responses API serverseitig anzubinden. Die Route nimmt eine Nutzeranfrage entgegen, ruft OpenAI auf und gibt eine strukturierte Antwort zurück.
- FastAPI-Route anlegen, die den OpenAI-Client mit dem serverseitigen Schlüssel initialisiert.
- Den Aufruf an die Responses API senden und
response_formatmit einem JSON Schema versehen, damit die Antwort garantiert valide strukturiert zurückkommt. - Die Antwort mit pydantic validieren, bevor sie an den Client weitergereicht wird, das deckt fehlerhafte Modellausgaben früh ab.
- Lokal testen, indem die Route mit unterschiedlichen Eingaben aufgerufen wird und die Schema-Validierung in einem Unit-Test abgesichert wird.
- Vor dem Staging-Deploy einen Lauf mit realistischen Eingabedaten durchführen, um Edge Cases zu entdecken.
Strukturierte Ausgaben verhindern viele der klassischen Backend-Parsing-Fehler, die entstehen, wenn ein Modell frei formulierten Text statt sauberem JSON liefert. OpenAI-SDKs unterstützen pydantic-Modelle direkt für diese Validierung, was die Fehlerquote in regulierten Workflows deutlich senkt. Wer das Schema einmal definiert hat, kann es im gesamten Backend wiederverwenden, für verschiedene Endpunkte und Anwendungsfälle gleich.
Node.js- und JavaScript-Beispiel: Express-Route, Streaming und SDK-Hinweise
Für Node.js-Backends gilt dasselbe Prinzip wie in Python: Der Schlüssel bleibt serverseitig, der Client bekommt nur die fertige Antwort.
- Eine Express-Route aufsetzen und die offizielle OpenAI-JavaScript-Bibliothek einbinden, statt eigene HTTP-Aufrufe zu schreiben.
- Je nach Anwendungsfall mit Streaming arbeiten und den
output_textschrittweise an den Client senden, das verbessert die gefühlte Antwortzeit merklich. - Mobile Apps rufen ausschließlich die eigene Proxy-Route auf, niemals direkt die OpenAI-API, der Schlüssel bleibt serverseitig.
- Für Echtzeitanwendungen kann ein WebSocket zwischen Client und Backend liegen, während das Backend selbst weiterhin klassisch mit OpenAI kommuniziert.
- Integrationstests mit gelockten OpenAI-Antworten schreiben, damit die Testsuite nicht von echten API-Kosten abhängt.
Dieses Muster lässt sich eins zu eins auf iOS- und Android-Apps übertragen: Die App spricht nur mit dem eigenen Backend, nie mit OpenAI direkt.
Sicherheit und Produktions-Best-Practices für den Live-Betrieb
Ein funktionierender Prototyp ist noch kein produktionsreifes System. Laut den Production Best Practices von OpenAI gehören Key-Rotation, ein Secrets Manager und Governance-Einstellungen auf Organisationsebene zur Grundausstattung vor dem Livegang.
- Schlüssel regelmäßig rotieren und nach dem Prinzip der minimalen Rechtevergabe pro Rolle vergeben.
- Audit-Logs führen, die nachvollziehbar machen, wer wann welche Anfrage ausgelöst hat.
- Eine IP-Allowlist einrichten und die Missbrauchsüberwachung aktiv beobachten, nicht nur beim Rollout.
- Bei strengen Datenaufbewahrungsanforderungen
store: falsesetzen, kombiniert mit verschlüsselten Reasoning-Elementen, um die eigene Compliance zu wahren.
Profi-Tipp: Prüfen Sie die Allowlist-Konfiguration vor jedem größeren Deploy erneut, ein vergessener Eintrag blockiert sonst den gesamten Produktionstraffic.
Strukturierte Ausgaben, Funktionsaufrufe und asynchrone Tools richtig einsetzen
response_format mit JSON Schema eignet sich, wenn die Antwort selbst ein strukturiertes Ergebnis sein soll, etwa eine Kategorisierung oder ein ausgefülltes Formular. Function-Calling eignet sich dagegen, wenn das Modell eine externe Aktion auslösen soll, etwa eine Datenbankabfrage oder einen Zahlungsvorgang.
Ein einmal definiertes Schema lässt sich im Backend mehrfach wiederverwenden und spart damit Entwicklungszeit bei neuen Endpunkten. Für langsame externe Vorgänge, etwa eine aufwendige Datenbankabfrage oder einen Batch-Job, bietet sich asynchrones Tool-Calling an: Das Modell arbeitet währenddessen weiter, und das Ergebnis wird später über eine call_id wieder verknüpft. Typische Fehlerquellen liegen hier in verlorenen Zuordnungen zwischen Job und Antwort, weshalb eine saubere ID-Verwaltung im Backend unverzichtbar bleibt.
Fehlercodes, Ratenlimits und Skalierungsstrategien für den Produktivbetrieb
Die Fehlercode-Dokumentation von OpenAI listet typische Reaktionen wie 401 bei fehlerhafter Authentifizierung, 429 bei Ratenlimits, 503 bei Überlastung und den speziellen Fehler cyber_policy bei sicherheitsrelevanten Anfragen.
- Bei 429-Fehlern mit exponentiellem Backoff und etwas Zufallsstreuung (Jitter) erneut anfragen, statt sofort erneut zu senden.
- Häufige Antworten cachen und mehrere Prompts in Stapelverarbeitung zusammenfassen, das senkt laut OpenAI die Last spürbar.
- Vor dem Rollout einen Lasttest fahren und Monitoring-Kennzahlen wie Latenz und Fehlerquote definieren, nicht erst danach.
Stapelverarbeitung und Caching sind dabei oft wirtschaftlicher als eine reine Erhöhung der Anfragefrequenz, besonders wenn das Budget für Tokens begrenzt ist.
Praxis-Perspektive: Wann sich ein maßgeschneidertes Integrationsprojekt lohnt
Eine Boilerplate-Integration reicht für ein Wochenendprojekt. Sobald Compliance-Anforderungen, mehrere Systeme oder eine langfristige Wartbarkeit ins Spiel kommen, zeigt sich schnell, wo generische Lösungen an ihre Grenzen stoßen: fehlende Anpassung an bestehende Prozesse, unklare Verantwortlichkeiten bei Updates, keine durchdachte Fehlerstrategie. Ein eigens entwickeltes Backend lässt sich dagegen genau auf die vorhandene Systemlandschaft zuschneiden und bleibt über Jahre pflegbar, statt bei der nächsten API-Änderung komplett neu gedacht werden zu müssen.
— Mintellity
Mintellity: Sichere und skalierbare ChatGPT-API-Integrationen aus einer Hand
Statt sich allein durch Dokumentation und Fehlercodes zu arbeiten, übernehmen wir die gesamte Integration, von der Backend-Architektur bis zum laufenden Betrieb. Unsere Referenzprojekte wie die Versuchsdatenbank für den Crashtest Service und die Plattform für Erlebnisgutscheine von mydays zeigen, wie wir komplexe Systeme zuverlässig anbinden.
- Individuelle Backend-Architektur statt generischer Boilerplate-Lösung.
- Sichere API-Anbindung mit Key-Management, Allowlisting und Monitoring.
- Laufende Wartung und Weiterentwicklung über die gesamte Projektlaufzeit.
Wer die KI-Einführung im Unternehmen strategisch begleiten lassen möchte, findet bei Menter passende Beratung und Coaching zu Prozessanalyse und Förderanträgen. Für die technische Umsetzung Ihrer KI-Lösungen sprechen wir gern unverbindlich über Ihr Projekt und klären in einem ersten Gespräch, welche Architektur zu Ihren Anforderungen passt.
FAQ
Wie integriere ich eine API in meine Anwendung?
Eine API-Integration beginnt mit einem Schlüssel oder Token, gefolgt von einer serverseitigen Route, die Anfragen entgegennimmt und an den API-Anbieter weiterleitet. Für die ChatGPT API bedeutet das konkret: Schlüssel erzeugen, Backend-Proxy bauen, Anfragen validieren und erst dann an die Responses API senden.
Ist die Nutzung der OpenAI API kostenlos?
Die OpenAI API ist nicht kostenlos, die Kosten richten sich nach Modellwahl und tatsächlichem Tokenverbrauch. Eine genaue Budgetabschätzung lohnt sich bereits vor dem ersten Produktivaufruf.
Wie aktiviere ich die ChatGPT API für mein Projekt?
Zunächst wird eine Organisation in der OpenAI-Plattform angelegt, danach ein API-Schlüssel erzeugt und sicher im Secrets Manager hinterlegt. Für den Produktivbetrieb empfiehlt OpenAI zusätzlich eine IP-Allowlist und eine klare Rollenvergabe innerhalb der Organisation.
Welche Schritte umfasst eine typische API-Integration?
Eine Integration läuft meist über Zugang und Schlüsselerstellung, Auswahl der passenden API und SDKs, Implementierung der Backend-Route, Absicherung durch Key-Management und Allowlisting sowie abschließende Tests in Staging vor dem Rollout. Jeder dieser Schritte baut auf dem vorherigen auf und sollte nicht übersprungen werden.
Wann lohnt sich die Chat Completions API statt der Responses API?
Die Chat Completions API bleibt sinnvoll für einfache Chat-Funktionen oder wenn eine bestehende Integration abwärtskompatibel bleiben muss. Für neue Projekte mit Tool-Calling oder strukturierten Ausgaben empfiehlt sich dagegen direkt die Responses API.