
Softwarewartung Best Practices: So bleibt Ihr System dauerhaft zuverlässig
Wartung ist eine systemweite Disziplin: Planen Sie sie als festen Prozess mit Konfigurationsverwaltung, Impact-Analyse und einer stehenden Kapazität für präventive Arbeiten. Wer Softwarewartung als Ad-hoc-Fehlerbehebung behandelt, zahlt später drauf. Entscheidend sind ein dokumentierter Wartungsplan, automatisierte Tests, kontinuierliche kleine Änderungen statt großer Sprünge und klar zugewiesene Ownership im Team.
Kurz gesagt:
- Architekturübersichten sollten Modulbeziehungen, Schnittstellen, Datenflüsse und häufig geänderte Bereiche zeigen und gemeinsam mit dem Quelltext gepflegt werden, damit sie aktuell bleiben.
- Externe Bibliotheken samt indirekten Abhängigkeiten sollten regelmäßig erfasst und hinter stabilen Schnittstellen gekapselt werden, damit Versionswechsel nicht unerwartet weitere Systemteile beeinträchtigen.
- Wenn eine Komponente häufig Probleme verursacht, sollte die Modernisierung dort in kleinen, geprüften Schritten beginnen; ein vollständiger Neuaufbau ist nicht automatisch sinnvoll.
- Eine Teststrategie, die nur Fehlerbehebungen abdeckt, lässt Anpassungen und Erweiterungen ungesichert; Verhaltenstests halten vor Eingriffen das bisherige Systemverhalten automatisch fest.
- Wartungsbudgets sollten sich an tatsächlichen Aufwänden vergangener Quartale je Wartungskategorie orientieren und so eine realistischere projektspezifische Wartungsquote als pauschale Schätzungen ermöglichen.
Systemkomplexität verstehen und Wartung auf Architektur-Ebene denken
Die meiste Zeit in der Wartung fließt nicht ins Schreiben von Code, sondern ins Verstehen dessen, was bereits da ist. Dieses Program Comprehension ist laut SEI/CMU-Report einer der größten Kostentreiber in langlebigen Systemen, und schlechte oder veraltete Dokumentation verschärft das Problem erheblich. Wer hier investiert, spart an anderer Stelle doppelt.
Architektur-Views helfen dabei, ein System schneller zu durchdringen, bevor überhaupt eine Zeile geändert wird. Vier Perspektiven haben sich in der Praxis bewährt:
- Modul-Übersichten zeigen, welche Komponenten existieren und wie sie zusammenhängen.
- Schnittstellen-Dokumentation macht sichtbar, was ein Modul nach außen verspricht.
- Datenfluss-Diagramme klären, wo Informationen entstehen und wohin sie wandern.
- Commit-Historien verraten, welche Bereiche häufig angefasst werden und damit instabil sind.
Konkret bedeutet das: Module-Maps, API-Contracts und Abhängigkeitsgraphen gehören als lebende Artefakte ins Projekt, nicht als einmalige Dokumentation zum Projektstart. Der SEI-Bericht beschreibt dazu Maintainability-Taktiken wie Kapselung und die Reduktion von Kopplung zwischen Komponenten, die sich direkt auf Kosten und Risiko eines Systems auswirken.
Profi-Tipp: Pflegen Sie Ihre Architektur-Diagramme im selben Repository wie den Code, dann verwaist die Dokumentation nicht bei jedem Refactoring.
Wartung als Disziplin auf Systemebene: Wartungsplan, Rollen und Prozessschritte
Ein Wartungsplan ist kein Nice-to-have, sondern laut ISO/IEC/IEEE 14764 ein zentrales Element eines funktionierenden Wartungsprozesses. Die Norm verlangt, dass Wartungsplanung bereits während der Entwicklung beginnt, nicht erst, wenn die Software produktiv ist und die ersten Tickets eintrudeln.
Ein vollständiger Plan deckt laut der NASA-Richtlinie NPR 7150.2 mehrere Dimensionen ab, die sich auch auf kleinere Unternehmenssoftware übertragen lassen:
- Scope und Zuständigkeiten: Wer ist für welchen Systemteil verantwortlich, und welche Änderungsarten fallen in die Wartung?
- Release- und Versionsplanung: In welchem Rhythmus werden Patches, Minor- und Major-Releases ausgeliefert?
- Migrations- und Retirement-Strategie: Wie werden Daten und Funktionen überführt, wenn eine Komponente abgelöst wird?
- Risikobewertung: Welche Änderungen bergen welches Ausfallrisiko, und wie wird dem begegnet?
Der eigentliche Arbeitsablauf folgt dann einem wiederkehrenden Muster: Triage der eingehenden Anfrage, Impact-Analyse zur Abschätzung der Tragweite, Implementierung und schließlich Review samt Abnahme. Wird dieser Zyklus von Anfang an in der Entwicklung mitgedacht, lassen sich spätere Wartungsprozesse viel leichter auf das bestehende System zuschneiden.
Abhängigkeitsmanagement: direkte und transitive Abhängigkeiten kontrollieren
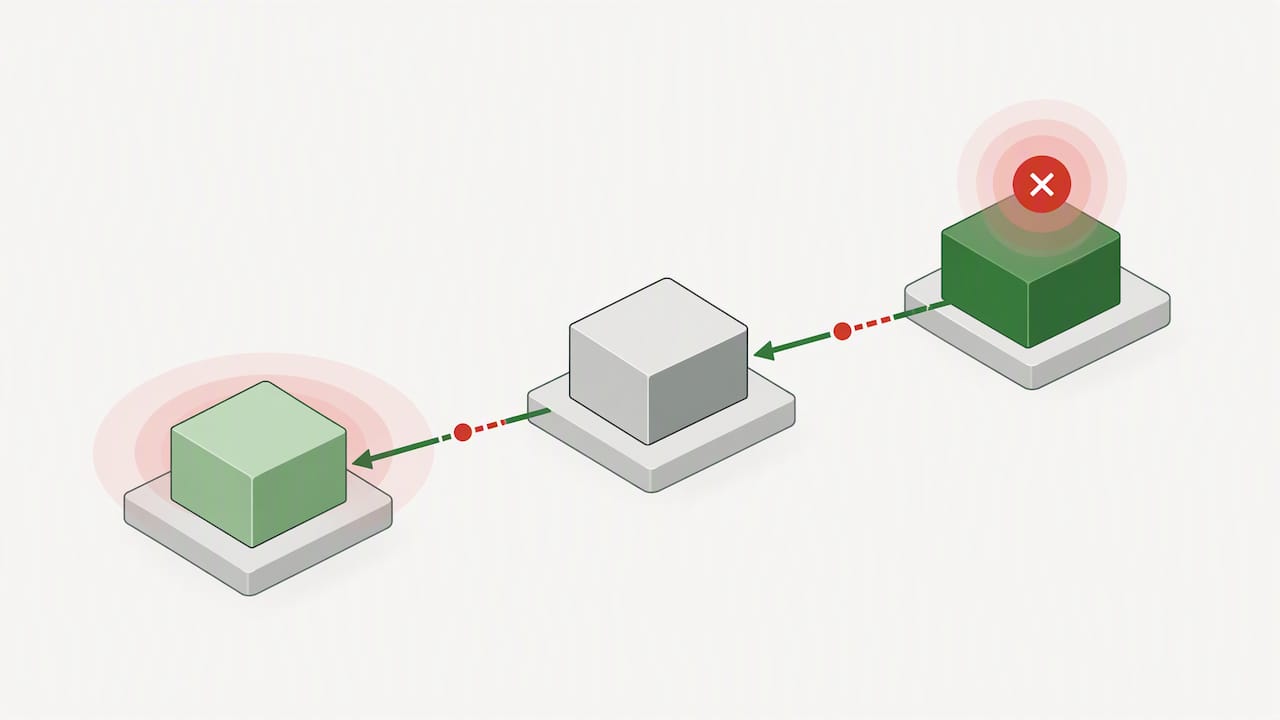
Jede Bibliothek, die Sie einbinden, bringt häufig weitere Abhängigkeiten mit, die Sie nie bewusst ausgewählt haben. Diese transitiven Abhängigkeiten sind oft die Quelle unerwarteter Sicherheitslücken oder Versionskonflikte, weil niemand sie aktiv im Blick behält.
Ein paar Maßnahmen reduzieren dieses Risiko spürbar:
- Abhängigkeitsgraphen regelmäßig erzeugen und direkte von transitiven Abhängigkeiten unterscheiden.
- Versionierungs-Policies festlegen, die End-of-Support-Termine und bekannte Sicherheitslücken berücksichtigen.
- Modulgrenzen so ziehen, dass eine externe Bibliothek hinter einer eigenen Schnittstelle gekapselt bleibt.
- API-Stabilität intern durchsetzen, damit ein Versionswechsel einer Abhängigkeit nicht quer durchs System durchschlägt.
Wer sich stärker an einen einzelnen Anbieter oder eine einzelne Technologie bindet, als es nötig wäre, erschwert sich spätere Wartungsentscheidungen zusätzlich. Unser Leitfaden zum Vermeiden von Vendor Lock-in beschreibt, wie sich diese Abhängigkeit von Anfang an begrenzen lässt.
Kapselung ist dabei keine akademische Übung: Sie entscheidet, ob ein Upgrade in einer Woche erledigt ist oder monatelange Nacharbeit auslöst. Je sauberer die Modulgrenzen, desto geringer die Wahrscheinlichkeit, dass eine transitive Abhängigkeit an unerwarteter Stelle ein System lahmlegt.
Stabilität vs. Wandel: inkrementelle Modernisierung statt Big-Bang
Ein komplettes Rewrite klingt verlockend, scheitert in der Praxis aber häufig an der schieren Komplexität eines gewachsenen Systems. Kleine, gut getestete Änderungen sind laut dem Software Engineering Guide der tragfähigere Weg, weil jede Änderung einzeln überprüfbar bleibt und Fehler schneller auffallen.
Drei Muster haben sich dabei etabliert:
- Strangler Fig: Neue Funktionalität wächst parallel zum Altsystem, bis dieses Stück für Stück abgelöst ist.
- Branch-by-Abstraction: Eine Abstraktionsschicht erlaubt es, die darunterliegende Implementierung auszutauschen, ohne den Rest des Systems zu berühren.
- Gezielte Reengineering-Slices: Statt des gesamten Systems wird nur der Teil überarbeitet, der nachweislich die meisten Probleme verursacht.
Ob sich ein umfassenderes Reengineering oder gar eine Ablösung lohnt, hängt davon ab, wie oft eine Komponente noch gebraucht wird und wie hoch ihr Wartungsaufwand im Verhältnis zum Nutzen ist.
Profi-Tipp: Beginnen Sie Reengineering immer an der Stelle, die am häufigsten Tickets verursacht, nicht an der, die am meisten über Legacy-Code geschrieben wird.
Operationalisierung: SCM, CI/CD, Impact-Analyse und Release-Management
Gute Prinzipien nützen wenig, wenn sie nicht im Tagesgeschäft ankommen. Konfigurationsverwaltung, automatisierte Pipelines und ein klarer Impact-Analyse-Workflow sind die Werkzeuge, die Wartung tatsächlich planbar machen.
Bei der Konfigurationsverwaltung (SCM) zahlen sich drei Gewohnheiten aus:
- Eine klare Branch-Strategie, die zwischen Hotfixes, geplanten Releases und experimentellen Änderungen unterscheidet.
- Change-Boards oder vergleichbare Freigabeprozesse für Änderungen mit höherem Risiko.
- Konsequente Release-Tags, damit jede produktive Version eindeutig zurückverfolgbar bleibt.
CI/CD-Pipelines ergänzen das um die technische Absicherung: Jede Änderung durchläuft automatisierte Regressionstests, bevor sie ausgeliefert wird, und Canary-Deployments mit Rollback-Mechanismen fangen Probleme ab, bevor sie alle Nutzer treffen. Das senkt das Risiko jeder einzelnen Wartungsänderung erheblich, weil Fehler lokal sichtbar werden, statt sich erst im produktiven Vollbetrieb zu zeigen.
Der Impact-Analyse-Workflow selbst folgt im besten Fall vier Schritten: Zunächst wird das gemeldete Problem reproduziert, damit klar ist, worum es wirklich geht. Danach wird der Umfang der betroffenen Module bestimmt, gefolgt von einer Aufwandsschätzung, die als Grundlage für die Priorisierung dient. Den Abschluss bildet eine formale Freigabe, bevor die Änderung in die Implementierung geht. Der SWEBOK betont, dass dieser Prozess reproduzierbare Ergebnisse liefern sollte, also dokumentiert, wer was repliziert hat und welche Module betroffen sind. Nur so lassen sich Wartungsbudgets später auch sachlich begründen.
Wenn Wartungsarbeiten auch Datenmigrationen oder Datenkonvertierungen umfassen, lohnt sich zudem ein Blick auf Datenqualität als eigenes Thema; der Praxis-Fahrplan für KMU von unserem Partner menter.digital zeigt, wie sich Datenqualitätsprobleme strukturiert angehen lassen, bevor sie sich in produktiven Systemen festsetzen.
Dokumentation, ADRs und Wissenssicherung
Entscheidungen, die heute selbstverständlich wirken, sind in zwei Jahren oft nicht mehr nachvollziehbar, wenn niemand sie festgehalten hat. Architecture Decision Records, kurz ADRs, lösen genau dieses Problem, indem sie knapp dokumentieren, warum eine bestimmte Lösung gewählt wurde und welche Alternativen verworfen wurden.
Drei Bausteine gehören in eine funktionierende Wissenssicherung:
- ADRs für die Entscheidungshistorie, kurz und versioniert direkt im Code-Repository.
- Runbooks für den Betrieb, die Schritt für Schritt beschreiben, wie auf typische Störungen reagiert wird.
- Eine Zuordnung zwischen Code und Architektur, damit neue Teammitglieder Module schneller einem Zweck zuordnen können.
Laut dem SEI/CMU-Report wirken ADRs und Runbooks am stärksten, wenn sie Teil des täglichen Workflows sind, etwa eingebunden in Pull-Requests oder CI-Checks, statt als separates Dokument irgendwo zu verstauben. Ob Dokumentation tatsächlich genutzt wird, lässt sich an einfachen Kennzahlen ablesen: Wie oft wird ein Dokument aufgerufen, und wie lange liegt die letzte Aktualisierung zurück? Beide Werte zeigen schnell, ob Wissen lebendig bleibt oder nur noch archiviert ist.
Testen & Regression: Teststrategie zur Absicherung von Wartungsarbeiten
Jede Änderung an einem bestehenden System trägt das Risiko, etwas zu zerstören, das vorher funktioniert hat. Charakterisierungstests fangen genau dieses Risiko ab: Sie dokumentieren das aktuelle Verhalten eines Systems automatisiert, bevor überhaupt etwas geändert wird, und schlagen Alarm, sobald sich das Verhalten unerwartet verschiebt.
Für den laufenden Wartungsbetrieb empfehlen sich drei Praktiken:
- Charakterisierungstests vor jedem größeren Eingriff in Legacy-Code anlegen, um das Ist-Verhalten festzuhalten.
- Selektive Regressionstests priorisieren, die gezielt die von einer Änderung betroffenen Module abdecken.
- Testpriorisierung in der CI-Pipeline so gestalten, dass risikoreiche Bereiche zuerst geprüft werden.
Die meisten Wartungstätigkeiten entfallen auf nicht-korrektive Maßnahmen wie Anpassungen und Erweiterungen, nicht auf reine Fehlerbehebung, so der SWEBOK. Das verschiebt den Fokus: Eine Teststrategie, die nur Bugfixes absichert, deckt damit nur einen kleinen Teil der tatsächlichen Wartungsarbeit ab.
Ownership, Team-Organisation und Bus-Factor-Reduktion
Ein System, das nur eine Person wirklich versteht, ist ein Risiko, das früher oder später zuschlägt. Klare Team-Ownership mit einem gepflegten Service-Katalog sorgt dafür, dass jederzeit nachvollziehbar ist, wer für welchen Systemteil verantwortlich ist.
Vier Maßnahmen reduzieren den sogenannten Bus-Factor, also die Abhängigkeit von Einzelpersonen, wirksam:
- Pairing und Rotation, damit Wissen über Systemteile nicht an einer Person hängen bleibt.
- Verpflichtende Code-Reviews, die gleichzeitig als Wissenstransfer zwischen Teammitgliedern funktionieren.
- Geteilte On-Call-Verantwortung statt eines einzelnen Ansprechpartners für alle Störungen.
- Regelmäßige Ownership-Reviews, die prüfen, ob die aktuelle Zuordnung noch zur Teamstruktur passt.
Praxisleitfäden zur Pflege großer Systemlandschaften empfehlen zudem, Bus-Factor und Technologiealter regelmäßig zu messen, um rechtzeitig Ressourcen umzuschichten, bevor ein Wissensverlust akut wird. Und wenn eine Komponente endgültig abgelöst wird, verdient das Retirement denselben Rahmen wie ein Projektstart: mit klarem Zeitplan, offiziellem Abschluss und Dokumentation dessen, was übernommen und was verworfen wurde.
Priorisierung, Finanzierung und SLAs
Nicht jede Wartungsanfrage verdient dieselbe Priorität. Eine Einteilung in korrektive, adaptive, perfektive und präventive Wartung hilft, Anfragen sachlich statt nach Lautstärke zu sortieren, wer sich gerade am meisten beschwert.
Für die Budgetierung lohnt sich der Blick auf historische Daten: Wie viel Aufwand floss in den letzten Quartalen tatsächlich in welche Wartungskategorie? Daraus lassen sich realistischere Wartungsquoten ableiten als aus reinen Schätzverfahren am Reißbrett.
Ein Wartungsvertrag braucht zudem klar definierte Bestandteile:
- Reaktionszeiten je nach Schweregrad eines Problems.
- Eskalationspfade, wenn eine erste Reaktion nicht ausreicht.
- Klare Abgrenzung, was im Vertrag enthalten ist und was gesondert beauftragt wird.
Unser Beitrag zu SLA-Kennzahlen und rechtlicher Absicherung geht genauer darauf ein, welche Elemente ein belastbares SLA für Softwarewartung tragen sollten.
Perspektive des Herausgebers: Warum Partnerschaften Wartung planbar machen
Aus unserer Sicht ist Kontinuität der unterschätzte Faktor in der Softwarewartung. Ein Team, das ein System über Jahre begleitet, versteht Eigenheiten, die in keinem Dokument stehen, und das spart in jeder Impact-Analyse wertvolle Zeit. Punktuelle Einsätze lösen akute Probleme, bauen aber selten dieses tiefe Systemverständnis auf.
Wartung, Modernisierung und die langfristige Produkt-Roadmap gehören für uns zusammen, nicht in getrennte Projekte mit getrennten Ansprechpartnern. Genau diese Verbindung macht den Unterschied zwischen reaktiver Fehlerbehebung und einer Software, die mit dem Unternehmen mitwächst.
— Mintellity
Wartung & Support von Mintellity: Der nächste Schritt
Planbare Softwarewartung entsteht nicht durch einzelne Maßnahmen, sondern durch ein Team, das Ihr System über Jahre begleitet und seine Eigenheiten kennt. Genau das bieten wir mit unserer Wartung und Support: laufende Betreuung, die Impact-Analyse, Sicherheitsupdates und Weiterentwicklung aus einer Hand verbindet, statt bei jedem Ticket neu anzusetzen.
Wenn Ihr System zusätzlich spürbar in die Jahre gekommen ist, ergänzen wir die Wartung um gezielte Softwaremodernisierung, ohne den laufenden Betrieb zu unterbrechen. Für Unternehmen, die eine echte technische Partnerschaft suchen statt eines austauschbaren Dienstleisters, lohnt sich ein Blick auf unsere Seite zu Software nach Maß. Lassen Sie uns besprechen, wie Ihr Wartungsvertrag konkret aussehen könnte.
FAQ
Was gehört in einen guten Wartungsplan für Software?
Ein vollständiger Wartungsplan legt Zuständigkeiten, Release-Rhythmus, Migrations- und Retirement-Strategie sowie eine Risikobewertung fest, wie es die NASA-Richtlinie NPR 7150.2 beschreibt. Wichtig ist, dass dieser Plan schon während der Entwicklung entsteht, nicht erst im produktiven Betrieb.
Welche Arten der Softwarewartung gibt es?
Üblich ist die Einteilung in korrektive Wartung (Fehlerbehebung), adaptive Wartung (Anpassung an neue Umgebungen), perfektive Wartung (funktionale Verbesserungen) und präventive Wartung (vorbeugende Maßnahmen). Nicht-korrektive Kategorien machen laut SWEBOK den weit überwiegenden Teil der tatsächlichen Wartungsarbeit aus.
Wie viel kostet Softwarewartung im Jahr?
Die Kosten hängen stark von Systemgröße, Technologiealter und Vertragsumfang ab, weshalb sich keine pauschale Zahl seriös nennen lässt. Realistischer ist es, historische Aufwände je Wartungskategorie auszuwerten und daraus eine projektspezifische Wartungsquote abzuleiten.
Was sollte ein Wartungsvertrag mit einer Softwareagentur enthalten?
Ein belastbarer Wartungsvertrag definiert Reaktionszeiten je Schweregrad, klare Eskalationspfade und eine eindeutige Abgrenzung der enthaltenen Leistungen. Unsere Leistungen rund um Wartung und Support umfassen genau diese Bestandteile für laufende Betreuungsverhältnisse.
Wie reduziert man Abhängigkeiten in einer bestehenden Software?
Direkte und transitive Abhängigkeiten lassen sich durch regelmäßig erzeugte Abhängigkeitsgraphen sichtbar machen, kombiniert mit klaren Versionierungs-Policies und einer konsequenten Kapselung hinter stabilen Schnittstellen. Modulgrenzen, die externe Bibliotheken isolieren, verhindern, dass ein Versionswechsel quer durchs gesamte System schlägt.
Quellen
- Guide to the Software Engineering Body of Knowledge Version 3.0 (SWEBOK) – Chapter 5
- IEEE/ISO/IEC 14764 – Software engineering — Maintenance
- SEI/CMU Report: Maintainability and architecture analysis
- NPR 7150.2 – Software Maintenance Plan (Auszug)
Autoritative Standards und Leitfäden
Diese Quellen bilden den fachlichen Rahmen dieses Beitrags:
- ISO/IEC/IEEE 14764: internationaler Prozessrahmen für Softwarewartung.
- SWEBOK Kapitel 5: Grundlagenwerk zur Softwarewartung.
- SEI/CMU-Report: methodische Tiefe zu Maintainability.
- NPR 7150.2: Checkliste für vollständige Wartungspläne.