
Zentrales Logging einführen: Der praktische Fahrplan für IT-Teams
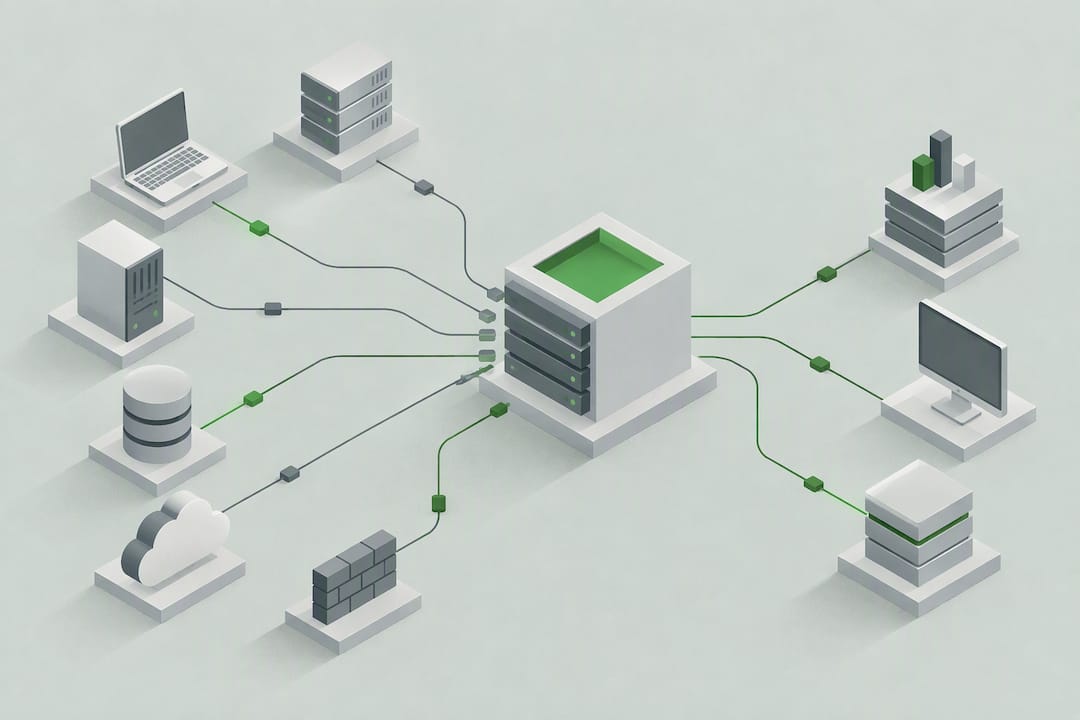
Starten Sie mit einem kleinen Pilot: Collector, ein zentrales Speicherziel, Basis-Alerting. Scope und Datenschutz klären Sie vorab, nicht hinterher. Diese Minimalarchitektur deckt die wichtigsten Signale einer Anwendung oder Serverklasse ab und lässt sich in einem begrenzten Piloten produktiv testen, bevor Sie weitere Systeme anbinden.
Kurz gesagt:
- Legen Sie Zweck, Zugriff und Aufbewahrungsfristen je Logkategorie im Protokollierungskonzept nach Artikel 30 DSGVO fest; pauschale Fristen gibt es nicht.
- Protokollieren Sie erfolgreiche und fehlgeschlagene Anmeldungen sowie Validierungsfehler mit Nutzerkennung, Host und genauem Zeitstempel, damit Angriffe erkennbar und Vorgänge später nachvollziehbar bleiben.
- Syslog überträgt und formatiert Protokolldaten, während ein SIEM sie zusätzlich korreliert, Alarmierungen auslöst und Vorfallabläufe automatisiert; die Werkzeuge erfüllen daher unterschiedliche Aufgaben.
- Synchronisieren Sie die Zeit aller Quellsysteme über einen Zeitdienst und testen Sie unter realistischer Last Warteschlangenverhalten, Latenz sowie Alarmketten, bevor die gestufte Einführung beginnt.
Kurz-Checkliste und Projektplan: vom Pilot zum Rollout
Ein sauberer Projektplan verhindert, dass zentrales Logging zum Nie-endenden Projekt wird. Legen Sie zuerst fest, welche Systeme, welche Ereignisse und welche Aufbewahrungsfristen gelten, und erst danach wählen Sie die Werkzeuge.
- Scope definieren: eine Anwendung oder Serverklasse, klar benannte Events, Aufbewahrungsfrist je Kategorie.
- Pilot aufbauen: Collector, Transportstrecke, zentrales Ziel, einfache Alert-Regel.
- Testfälle prüfen: Signalabdeckung, Latenz zwischen Ereignis und Anzeige, Umgang mit sensiblen Feldern.
- Akzeptanzkriterien abnehmen: vollständige Korrelation über Zeitstempel, keine unmaskierten sensiblen Daten, stabiles Queue-Verhalten unter Last.
- Rollback-Option bereithalten: alte Logquellen parallel betreiben, bis der Pilot die Kriterien erfüllt.
Profi-Tipp: Dokumentieren Sie die Akzeptanzkriterien vor dem Pilotstart, nicht danach, sonst verschiebt sich die Messlatte mit jedem Testlauf.
Architektur und Komponenten: Collector, Transport, Storage, Analyse
Zentrales Logging umfasst mehrere Rollen, die Sie unabhängig voneinander dimensionieren. Ein Collector sammelt Rohdaten an der Quelle, der Transport bringt sie zuverlässig weiter, Storage hält sie vor, und die Analyseebene macht sie durchsuchbar und alarmfähig.
- Agent oder Sidecar läuft dicht am Prozess und eignet sich für containerisierte Workloads mit wenig Overhead.
- DaemonSet sammelt pro Knoten und passt zu Kubernetes-Clustern mit vielen kleinen Diensten.
- Gateway-Collector bündelt mehrere Quellen, bevor Daten das Netzwerksegment verlassen, und reduziert so die Zahl direkter Backend-Verbindungen.
- Transport über Syslog oder OTLP mit Queues zwischen den Stufen fängt Lastspitzen ab und verhindert Datenverlust bei kurzzeitigen Ausfällen.
- Storage folgt meist einer Hot-Warm-Cold-Strategie: aktueller Index für Analyse, ältere Daten komprimiert, Archivdaten unveränderbar abgelegt.
Das BSI empfiehlt eine zentrale Protokollierungsinfrastruktur mit regelmäßigen Prüffristen und einer unveränderten Originalform der Logs, damit die Daten im Ernstfall auch forensisch belastbar bleiben.
Datenschutz und Compliance: Protokollierungskonzept und Löschfristen
Ein Logging-System ohne ein IT-Sicherheit Schulung für Mitarbeiter begleitendes Datenschutzkonzept ist ein Risiko, kein Werkzeug. Bevor Sie Quellen anbinden, braucht es eine saubere Dokumentation, die festlegt, was wie lange gespeichert wird und wer Zugriff erhält.
- Protokollierungskonzept als Teil des Verzeichnisses von Verarbeitungstätigkeiten nach Artikel 30 DSGVO, mit Zweck, Umfang und Aufbewahrungsdauer je Logquelle.
- Inventarisierung aller Logquellen, inklusive Format, Speicherort und Auswertungstool, wie es der Baustein 43 „Protokollieren“ vorschlägt.
- Zugriffskonzept mit rollenbasierten Berechtigungen und Pseudonymisierung personenbezogener Felder, wo immer die Analyse das zulässt.
- Löschfristen differenziert nach Kategorie festlegen und gegenüber Aufsichtsbehörden dokumentierbar machen.
Wer die rechtlichen Anforderungen tiefer durchdringen will, findet in unserem Beitrag zu DSGVO-konformer Software weiterführende Hinweise zur Dokumentationspflicht.
Implementierung: Schritt für Schritt vom Pilot zur Produktion
Der Weg vom Pilot zur Produktion gelingt am besten in klar abgegrenzten Phasen. Vorbereitung, Testlauf und gestaffelter Rollout greifen ineinander, ohne dass Sie den Betrieb an einem Tag umstellen müssen.
- Vorbereitung: Zeitsynchronisation über NTP auf allen Quellsystemen sicherstellen, denn ohne synchronisierte Zeitstempel bleibt die Ursachenanalyse eingeschränkt.
- Inventar und Onboarding-Template: ein wiederverwendbares Schema für jede neue Quelle, damit Feldnamen und Formate konsistent bleiben.
- Signalabdeckung testen: prüfen, ob alle erwarteten Ereignistypen ankommen, bevor Sie weitere Dienste anschließen.
- Datenschutz-Checks: Stichproben auf unmaskierte sensible Felder, bevor der Produktivbetrieb startet.
- Lasttests: Queue-Verhalten und Latenz unter realistischer Last beobachten, nicht nur im Leerlauf.
- Alert-Validierung: jede Alarmregel mindestens einmal bewusst auslösen, um die Kette von der Erkennung bis zur Benachrichtigung zu prüfen.
- Gestaffelter Rollout: Quelle für Quelle anbinden, Collector-Health laufend überwachen, Nachbesserungen direkt einpflegen.
Profi-Tipp: Binden Sie neue Quellen nie alle gleichzeitig an, sondern in kleinen Wellen, damit sich ein fehlerhaftes Onboarding nicht sofort auf das gesamte System auswirkt.
Betrieb und Skalierung: Collector-Topologie, Queues, Failover
Ein zentrales Logging-System wächst mit der Zahl der Quellen, und genau dort entstehen die meisten Engpässe. Horizontale Skalierung der Collector-Ebene und sauberes Sharding verhindern, dass einzelne Knoten zum Flaschenhals werden.
- Separate Skalierung je Signaltyp, denn Logs, Metriken und Traces verhalten sich unter Last unterschiedlich, wie die OpenTelemetry-Dokumentation beschreibt.
- Queue- und Speicherauslastung als Frühindikator beobachten, nicht erst reagieren, wenn der Collector bereits Daten verwirft.
- Redundante Puffer und ausreichend dimensionierte Export-Queues einplanen, damit kurzzeitige Backend-Ausfälle keine Lücken im Log hinterlassen.
- Mindestreplikate für kritische Collector-Instanzen vorsehen, besonders dort, wo sicherheitsrelevante Ereignisse durchlaufen.
Log-Qualität: welche Events gehören ins zentrale System
Nicht jedes Ereignis muss protokolliert werden, aber bestimmte Kategorien sind aus Sicherheitssicht Pflicht. Die OWASP Top Ten stufen unzureichendes Logging als kritisches Risiko ein und empfehlen insbesondere fehlgeschlagene Logins und Validierungsfehler mit Kontext anzureichern.
- Fehlgeschlagene und erfolgreiche Login-Versuche, da sie Angriffsmuster früh sichtbar machen.
- Validierungsfehler und sicherheitsrelevante Transaktionen als Audit-Trail für spätere Nachvollziehbarkeit.
- Kontextfelder wie Nutzer- oder Session-ID, Host, Trace- und Span-IDs sowie ein präziser Zeitstempel.
Zentrale Speicherung und nahezu Echtzeit-Auswertung werden bereits bei vergleichsweise überschaubaren Systemlandschaften notwendig, wie eine Studie zur IT-Frühwarnung zeigt. Das bedeutet für die Aufbewahrung: Zweckbindung je Kategorie, differenzierte Löschfristen und eine klare Trennung zwischen aktivem Index für die laufende Analyse und Archiv für forensische Zwecke.
Alarmierung und Integration in den Incident-Response-Prozess
Ein Alert, der niemand beachtet, weil er zu oft kommt, ist kein Alert mehr, sondern Hintergrundrauschen. Schwellwerte sollten Sie deshalb im Pilot bewusst testen, bevor sie produktiv scharf geschaltet werden.
- Alert-Frequenz im Testlauf beobachten und Schwellwerte so lange anpassen, bis die Trefferquote belastbar ist.
- Eskalationsmatrix mit klaren Verantwortlichkeiten definieren, bevor der erste echte Vorfall eintritt.
- Schnittstelle zum ITSM-Tool einrichten, damit ein Alert automatisch ein Ticket erzeugt statt in einer Inbox zu versanden.
- Alarmkette regelmäßig testen, im Pilot wie im Produktivbetrieb, damit niemand erst im Ernstfall merkt, dass eine Benachrichtigung ins Leere läuft.
Standards und Techniken: Syslog, SIEM und OpenTelemetry im Vergleich
Syslog ist in erster Linie ein Transport- und Formatstandard, während ein SIEM zusätzlich Korrelation, Alarmierung und automatisiertes Incident-Management bietet und damit mehr leistet als ein reines Syslog-Setup. Beide Ebenen sauber zu trennen hilft bei der Werkzeugauswahl.
- Syslog für den Transport, SIEM für Analyse und Alarmierung, selten beides aus demselben Werkzeug.
- OpenTelemetry Collector mit Prozessoren wie Batch, Filter oder dem neueren Unroll-Processor, der gebündelte JSON-Arrays in einzelne Events auflöst.
- Memory-Limiter-Konfiguration nicht vergessen, da sie entscheidet, ob der Collector bei Lastspitzen kontrolliert drosselt oder Daten verliert.
- Entscheidung zwischen Self-Hosting und Managed Backend abhängig von Compliance-Anforderungen und vorhandener Betriebskapazität treffen.
Perspektive: Warum ein projektbasierter Implementierungsansatz oft schneller zum Ziel führt
Viele Teams unterschätzen, wie viel Abstimmungsaufwand allein das Protokollierungskonzept verschlingt, bevor überhaupt ein Collector läuft. Ein Ansatz, der Prozessnähe und technische Umsetzung von Anfang an zusammendenkt, spart genau dort Zeit, wo interne Teams oft stecken bleiben: bei der Integration in bestehende Systeme und beim sauberen Datenschutz-Fundament. Eine begleitende Wartung nach dem Rollout verhindert, dass das System wieder veraltet.
— Mintellity
Kurzangebot: Unterstützung bei Einführung und Betrieb
Wir entwickeln maßgeschneiderte Lösungen, die sich an Ihre bestehende IT-Infrastruktur anpassen, statt Sie auf ein starres Standardwerkzeug festzulegen. Von der Konzeption über die Integration bis zum Datenschutzkonzept begleiten wir die Einführung und bleiben auch danach als Ansprechpartner für Wartung und Weiterentwicklung an Bord.
- Konzeption und Architekturberatung für Ihr zentrales Logging-Vorhaben.
- Integration in bestehende Toollandschaft über unsere Individuelle Softwareentwicklung.
- Laufende Betreuung über Wartung und Support, damit das System mit Ihren Anforderungen mitwächst.
Für Projekte mit vergleichbarer technischer Tiefe zeigt unsere Referenz zur Köhler Lagerapp, wie wir kundenspezifische Lösungen bauen. Wenn Sie wissen wollen, wie Ihr Logging-Vorhaben konkret aussehen könnte, sprechen Sie uns für ein Erstgespräch an.
FAQ
Was bedeutet zentrales Logging einführen konkret?
Zentrales Logging einführen heißt, verteilte Protokolldaten aus Anwendungen und Servern über Collector und Transportstrecke an einem zentralen Ziel zu sammeln, statt sie lokal verstreut liegen zu lassen. So lassen sich Ereignisse über Systemgrenzen hinweg korrelieren und auswerten.
Welche Events müssen zwingend protokolliert werden?
Fehlgeschlagene und erfolgreiche Login-Versuche sowie Validierungsfehler sollten laut OWASP protokolliert werden, da sie Angriffsmuster sichtbar machen. Ergänzend empfehlen sich sicherheitsrelevante Transaktionen mit Kontextfeldern wie Nutzer-ID und Zeitstempel.
Wie lange müssen Logdaten aufbewahrt werden?
Die Aufbewahrungsfrist richtet sich nach Zweck und Kategorie der Daten und muss im Protokollierungskonzept nach Artikel 30 DSGVO dokumentiert sein. Pauschale Fristen gibt es nicht, deshalb legen Unternehmen die Dauer je Logquelle selbst fest und dokumentieren sie gegenüber Aufsichtsbehörden.
Was ist der Unterschied zwischen Syslog und SIEM?
Syslog ist ein Transport- und Formatstandard für Protokolldaten, während ein SIEM zusätzlich Korrelation, Alarmierung und automatisiertes Incident-Management bietet. Beide Ebenen ergänzen sich, ersetzen sich aber nicht gegenseitig.
Wie startet man am besten mit zentralem Logging?
Der sinnvollste Einstieg ist ein kleiner Pilot mit einer Anwendung oder Serverklasse, klar definierten Events und einer einfachen Alert-Regel. Erst wenn Signalabdeckung, Latenz und Datenschutz-Checks im Pilot bestehen, folgt der gestaffelte Rollout auf weitere Systeme.